
Ketika AI tidak lagi hanya memberi saran kode
Bayangkan sebuah sistem yang bukan sekadar menyarankan baris kode, tetapi mampu membaca basis kode yang sangat besar, memahami konteks masalah, menjalankan alat bantu, menemukan sumber bug, lalu mengusulkan perbaikan yang relevan. Inilah arah perkembangan Agentic AI dalam pengembangan perangkat lunak. Namun, kemampuan tersebut menuntut dua hal yang sering menjadi hambatan: pemahaman konteks sangat panjang dan kecepatan inferensi yang tetap responsif.
NVIDIA memperkenalkan dukungan untuk eksperimen Qwen3.8-Flash-Next pada platform NVIDIA GB300 NVL72 sebagai jawaban atas kebutuhan tersebut. Kombinasi model terbuka, arsitektur inferensi yang efisien, dan komputasi berskala rack membuka peluang bagi Agentic AI untuk bekerja lebih dekat dengan kebutuhan nyata tim developer.
Apa itu Qwen3.8-Flash-Next?
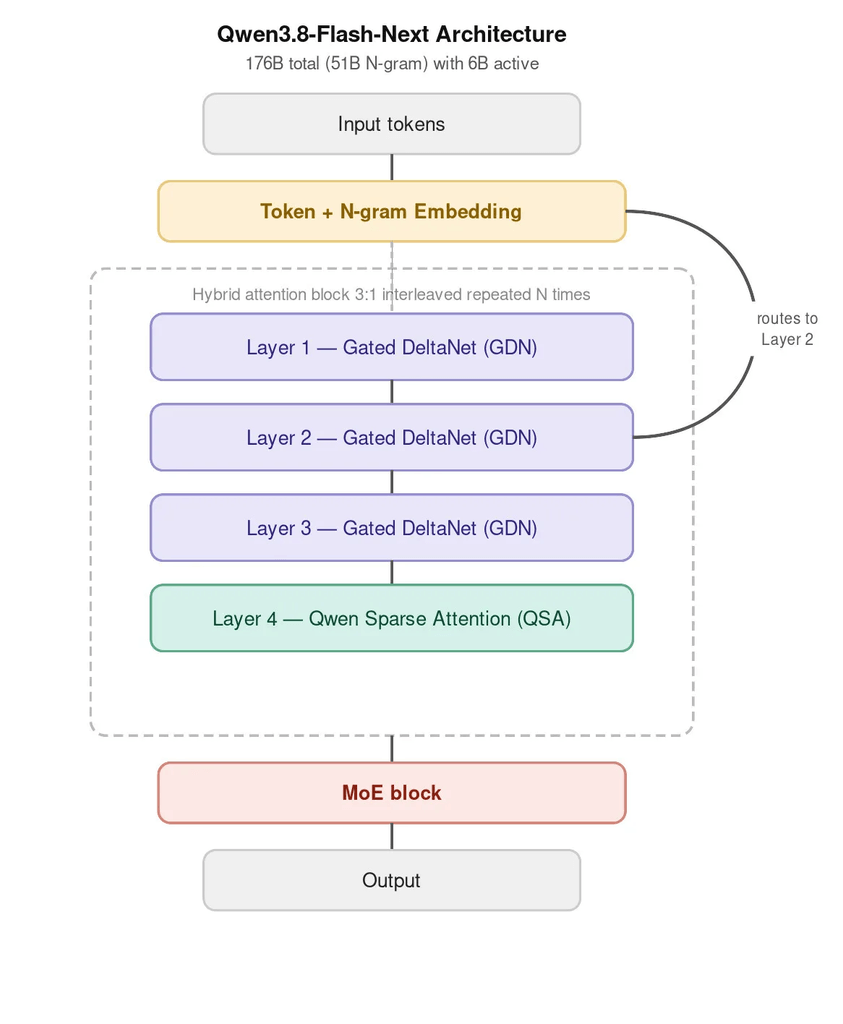
Qwen3.8-Flash-Next adalah model multimodal Mixture-of-Experts atau MoE dari Alibaba yang dirancang untuk beban kerja dengan konteks besar. Model utamanya memiliki 125 miliar parameter, dengan sekitar 6 miliar parameter aktif pada setiap token. Pendekatan MoE memungkinkan model mengaktifkan “ahli” yang paling relevan untuk tugas tertentu, sehingga penggunaan komputasi dapat menjadi lebih efisien dibanding menjalankan seluruh parameter secara penuh.
Model ini memiliki jendela konteks native hingga 262.144 token dan dapat diperluas hingga 1 juta token melalui YaRN. Dalam praktiknya, kemampuan ini penting ketika Agentic AI perlu menelusuri banyak file, dokumentasi internal, riwayat perubahan kode, hasil pengujian, serta instruksi pengguna dalam satu rangkaian pekerjaan.
Alih-alih kehilangan konteks saat percakapan atau tugas menjadi panjang, model dapat mempertahankan pemahaman yang lebih utuh. Hal ini membuatnya relevan bukan hanya untuk coding assistant, tetapi juga pemrosesan dokumen, otomasi berbasis tool, dan alur kerja enterprise yang kompleks.
Mengapa konteks panjang menjadi tantangan bagi Agentic AI?
Sistem AI untuk coding sering kali harus menangani repositori dengan ribuan hingga jutaan baris kode. Saat konteks bertambah, arsitektur attention konvensional membutuhkan komputasi dan memori KV cache yang makin besar. Dampaknya adalah biaya inferensi meningkat, latensi bertambah, dan pengalaman pengguna menjadi kurang interaktif.
Qwen3.8-Flash-Next mengatasi tantangan ini dengan arsitektur hybrid yang menggabungkan Gated DeltaNet (GDN) dan Qwen Sparse Attention (QSA).
- Gated DeltaNet digunakan pada tiga dari setiap empat layer untuk merangkum konteks historis ke dalam state berukuran tetap. Pendekatan ini membantu mengurangi pertumbuhan KV cache ketika urutan input semakin panjang.
- Qwen Sparse Attention digunakan pada layer berikutnya untuk mengambil informasi paling relevan dari seluruh konteks secara presisi.
- Seleksi berbasis blok membuat QSA tidak harus memproses setiap token secara setara. Sistem dapat mengidentifikasi bagian konteks yang paling penting, sehingga beban attention dan indexing menjadi lebih efisien.
Arsitektur ini membuat Agentic AI lebih siap menghadapi pekerjaan yang membutuhkan pemahaman lintas file dan lintas tahapan. Contohnya, agen dapat meninjau laporan error, membuka modul terkait, mencari dependensi, lalu mengevaluasi dampak perbaikan tanpa harus mengorbankan terlalu banyak konteks penting.
Efisiensi inferensi untuk workflow coding yang lebih responsif
Keunggulan teknis tidak cukup jika sebuah model tetap lambat saat digunakan dalam workflow sehari-hari. Dalam pengembangan perangkat lunak, respons yang cepat menentukan apakah AI terasa sebagai rekan kerja produktif atau justru menjadi hambatan tambahan.
Menurut benchmark yang dipublikasikan Alibaba, Qwen Sparse Attention dapat memberikan percepatan hingga 7,6 kali pada tahap prefill dan 4,9 kali pada decoding dibandingkan full attention untuk beban kerja konteks 1 juta token. Dalam pengujian online serving dengan cache berat dan tingkat prefix-cache hit 90%, Qwen3.8-Flash-Next juga mencapai throughput prefill hingga 8,6 kali lebih tinggi daripada Qwen3.7-Plus.
Angka tersebut menunjukkan arah yang penting: Agentic AI tidak hanya membutuhkan model yang cerdas, tetapi juga sistem yang mampu menjaga efisiensi ketika tugas berkembang dari prompt singkat menjadi proyek kompleks. Bagi developer, ini berarti potensi waktu tunggu yang lebih rendah saat agen membaca konteks, merencanakan langkah, atau menghasilkan tindakan berikutnya.
Peran NVIDIA GB300 NVL72 dalam skala produksi
NVIDIA GB300 NVL72 mengintegrasikan 72 GPU NVIDIA Blackwell Ultra dalam satu platform rack-scale. Sistem ini memiliki domain NVIDIA NVLink berskala besar dengan komunikasi all-to-all hingga 130 TB/s. Konektivitas tersebut penting bagi model MoE karena lalu lintas antar-expert dapat menjadi bottleneck apabila harus melewati jaringan tradisional.
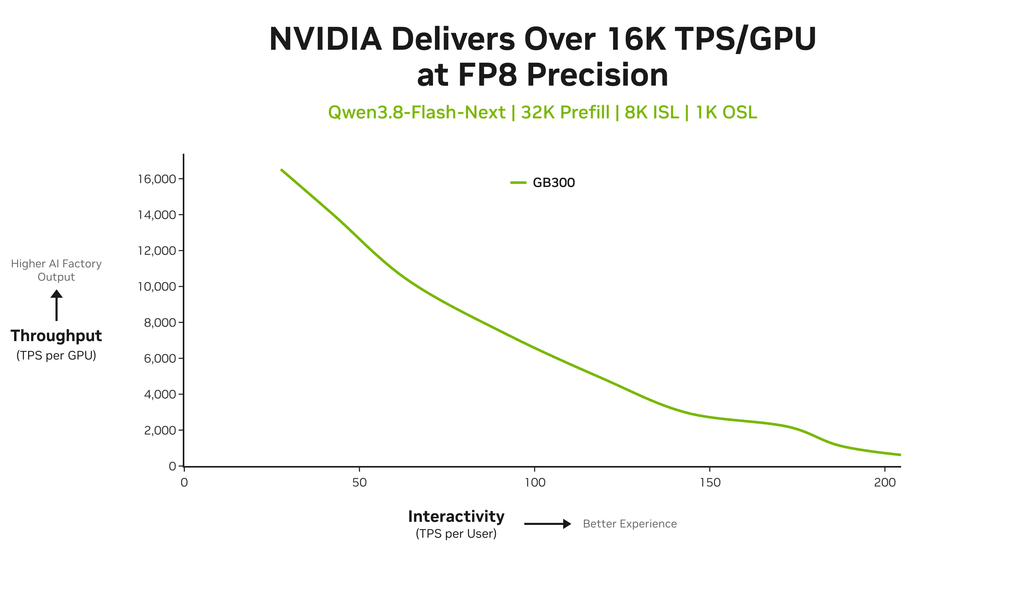
Pada NVIDIA GB300 NVL72, Qwen3.8-Flash-Next mampu mencapai throughput lebih dari 16.000 token per detik per GPU dan lebih dari 200 token per detik per pengguna. Kapasitas ini mendukung penggunaan Agentic AI secara lebih interaktif, bahkan ketika banyak pengguna menjalankan tugas coding secara bersamaan.
Bagi organisasi, kemampuan ini dapat diterjemahkan menjadi beberapa manfaat praktis:
- Mendukung asisten coding untuk banyak developer dalam satu lingkungan.
- Menjaga respons aplikasi saat agen perlu memproses konteks panjang.
- Meningkatkan kapasitas eksperimen sebelum solusi diterapkan pada skala produksi.
- Mengurangi kompromi antara throughput, latensi, dan kualitas pemahaman konteks.
Dari prototipe lokal menuju penerapan enterprise
Adopsi teknologi tidak harus langsung dimulai dari infrastruktur berskala besar. Qwen3.8-Flash-Next juga dapat dijalankan pada perangkat NVIDIA lokal, termasuk NVIDIA DGX Station, klaster DGX Spark, serta workstation dengan empat GPU NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition.
Fleksibilitas ini memberikan jalur yang lebih realistis bagi tim untuk membangun dan mengevaluasi workflow Agentic AI. Developer dapat membuat prototipe lokal, menguji kualitas respons terhadap repositori atau data internal, lalu meningkatkan skala ke GB300 NVL72 saat aplikasi siap melayani pengguna dalam jumlah besar.
Untuk penyesuaian model, NVIDIA menyediakan NeMo AutoModel dengan dukungan checkpoint Hugging Face pada hari pertama. Tim dapat melakukan supervised fine-tuning penuh atau LoRA yang lebih hemat memori. Selanjutnya, NeMo RL menyediakan opsi reinforcement learning untuk menyelaraskan perilaku agen dengan tujuan spesifik, seperti kualitas perbaikan bug, kepatuhan terhadap standar coding, atau efektivitas penggunaan tool.
Pilihan inference engine yang lebih terbuka
Keberhasilan penerapan Agentic AI juga bergantung pada kebebasan memilih stack inferensi. NVIDIA mendukung beberapa opsi, termasuk SGLang, vLLM, TokenSpeed, dan TensorRT-LLM. Pilihan ini memungkinkan tim menyesuaikan strategi deployment berdasarkan kebutuhan kontrol performa, ekosistem open source, atau integrasi infrastruktur yang telah digunakan.
Pendekatan terbuka tersebut memberi ruang bagi perusahaan untuk bereksperimen tanpa harus terikat pada satu jalur implementasi. Tim engineering dapat memilih metode yang paling sesuai untuk prototyping, fine-tuning, optimasi throughput, hingga serving di lingkungan production.
Kesimpulan
Qwen3.8-Flash-Next menunjukkan bahwa masa depan Agentic AI untuk coding tidak hanya ditentukan oleh ukuran model, tetapi oleh kemampuan mengelola konteks panjang secara efisien dan menyajikan respons cepat dalam skala besar. Kombinasi Gated DeltaNet, Qwen Sparse Attention, dan arsitektur MoE dirancang untuk menjawab hambatan utama pada tugas berbasis konteks intensif.
Dengan performa GB300 NVL72, dukungan post-training melalui NVIDIA NeMo, serta pilihan inference engine yang luas, developer memiliki fondasi yang lebih matang untuk membawa Agentic AI dari eksperimen menjadi bagian nyata dari workflow pengembangan perangkat lunak. Pada akhirnya, teknologi ini berpotensi mengubah AI dari sekadar alat pelengkap menjadi agen yang mampu membantu developer menavigasi kompleksitas coding modern secara lebih cerdas, cepat, dan terukur.
Sumber: NVIDIA Technical Blog


Leave a Reply
You must be logged in to post a comment.