
Ketika kebutuhan komputasi meningkat, banyak organisasi langsung membayangkan penambahan GPU, rak, dan pasokan listrik. Namun, pertanyaan yang lebih penting justru: seberapa banyak pekerjaan bernilai yang benar-benar dihasilkan dari setiap megawatt yang sudah tersedia? Di era model generatif dan layanan real-time, kemampuan sebuah AI factory tidak lagi cukup diukur dari kapasitas perangkat kerasnya. Ukuran yang lebih relevan adalah token yang dapat diproduksi secara andal, efisien, dan sesuai prioritas bisnis. Inilah perubahan cara pandang yang mendorong NVIDIA DSX: mengubah infrastruktur dari kumpulan komponen menjadi sistem produksi komputasi yang terorkestrasi.
Mengapa megawatt menjadi batas utama pertumbuhan?
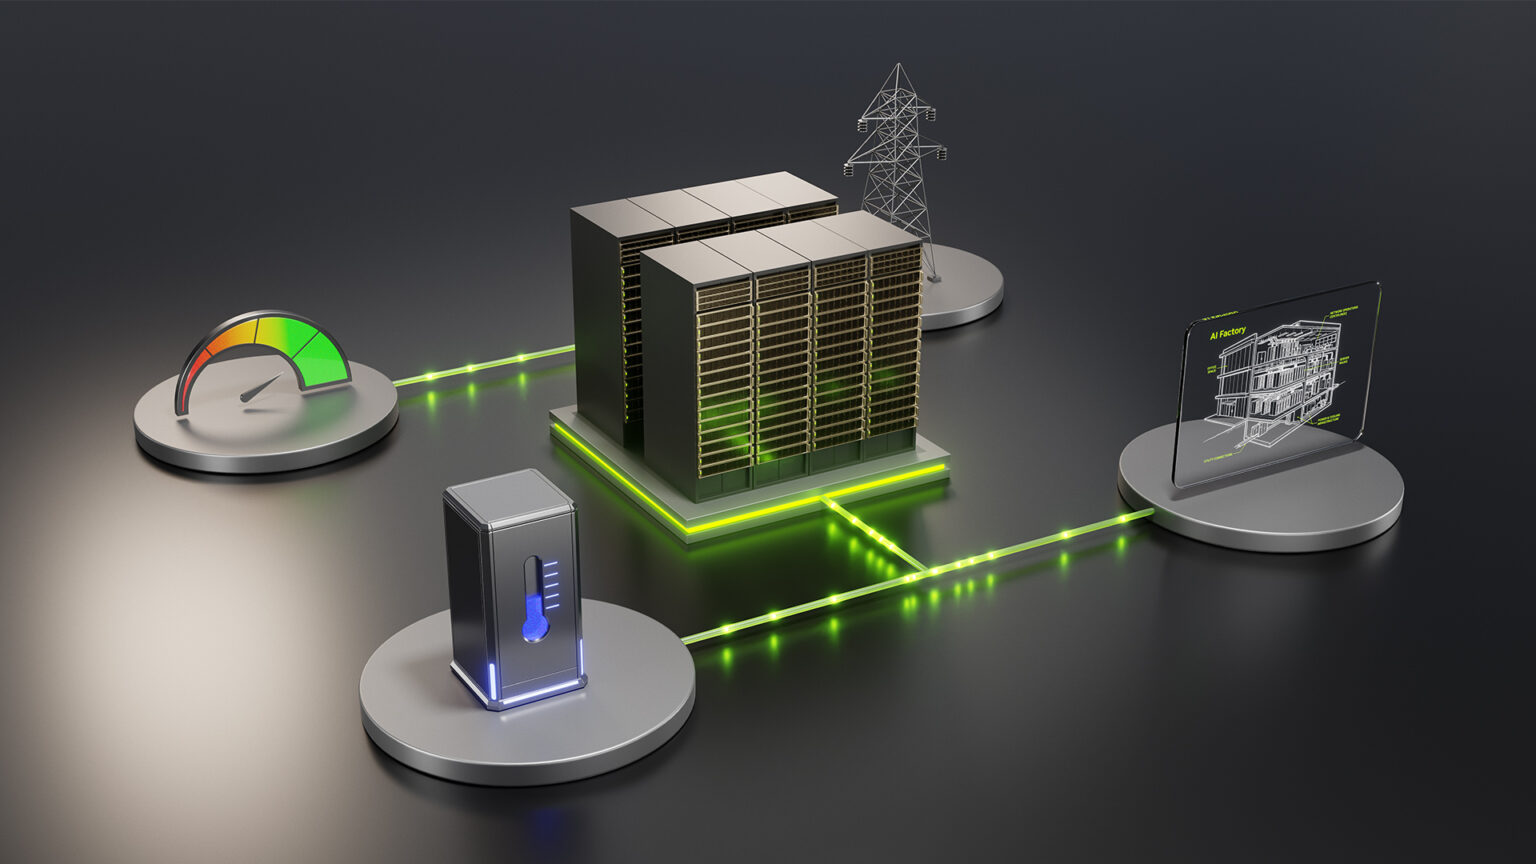
Permintaan terhadap AI membuat pusat data menghadapi kendala yang nyata: listrik, pendinginan, dan ruang fisik. Menambah daya bukan proses instan; pembangunan transmisi dan fasilitas baru dapat membutuhkan waktu bertahun-tahun. Karena itu, operator tidak dapat mengandalkan pendekatan “lebih banyak daya, lebih banyak komputasi” saja.
Dalam konteks ini, efisiensi bukan sekadar menurunkan tagihan listrik. Efisiensi berarti memastikan daya yang telah dialokasikan benar-benar berubah menjadi pekerjaan produktif. Daya yang menganggur akibat penyediaan statis, waktu GPU menunggu, atau proses pemulihan yang lambat merupakan kapasitas yang hilang. Bagi perusahaan yang menyediakan layanan inferensi, kapasitas hilang berarti respons yang lebih lambat, biaya lebih tinggi, atau peluang melayani pengguna yang terlewat.
Apa yang dimaksud dengan produksi token per megawatt?
Token adalah satuan keluaran praktis untuk mengukur pekerjaan model bahasa dan banyak beban kerja generatif. Produksi token per megawatt menggambarkan seberapa efektif sebuah AI factory mengonversi energi menjadi keluaran komputasi. Metrik ini membantu pengelola infrastruktur melihat kinerja secara menyeluruh.
Pendekatan tersebut mencakup beberapa lapisan yang saling bergantung:
- Komputasi: GPU harus menerima daya sesuai karakter beban kerja, baik untuk pelatihan maupun inferensi.
- Jaringan dan penyimpanan: GPU berkecepatan tinggi tetap dapat terhambat bila data atau komunikasi antar-node tidak mengimbangi.
- Daya dan pendinginan: distribusi listrik serta pembuangan panas menentukan seberapa padat sistem dapat dijalankan dengan aman.
- Operasi: penjadwalan, checkpoint, pemulihan, dan pemantauan menentukan berapa lama sumber daya benar-benar produktif.
Nilai utama model ini adalah menghindari optimasi terpisah. GPU yang lebih cepat tidak otomatis memberi lebih banyak token apabila jaringan menunggu atau sebagian daya tertahan sebagai cadangan yang tidak pernah dipakai.
DSX MaxLPS: Mengambil kembali kapasitas yang terjebak
NVIDIA DSX MaxLPS dirancang untuk memantau konsumsi daya pada tingkat GPU dan rak secara real-time, kemudian mengalokasikan kembali ruang daya yang tersedia berdasarkan jenis beban kerja. Pendekatan ini penting karena beban pelatihan dan inferensi tidak mengonsumsi daya dengan pola yang sama. Ketika semua node diberi batas tetap untuk menghadapi skenario puncak, sebagian kapasitas dapat terbuang pada kondisi operasi normal.
Validasi Lambda pada klaster lima rak dan 19 node berbasis NVIDIA HGX B200 memperlihatkan potensi pendekatan ini. Dengan anggaran daya fasilitas yang sama, 19 node yang berjalan pada kebijakan 85% daya menghasilkan sekitar 5 juta token per detik. Angka tersebut setara peningkatan throughput klaster 24% dibandingkan 16 node pada daya penuh, sekaligus meningkatkan performa per watt sebesar 23%.
Temuan ini tidak berarti setiap pusat data otomatis akan memperoleh hasil identik. Profil model, campuran pelanggan, rancangan rak, dan kebijakan layanan tetap menentukan. Namun, hasil tersebut menegaskan satu prinsip penting: pembatasan daya yang dikelola secara dinamis dapat menghasilkan lebih banyak keluaran AI daripada penyediaan daya statis.
DSX Flex: Menjadikan pusat data lebih responsif terhadap grid
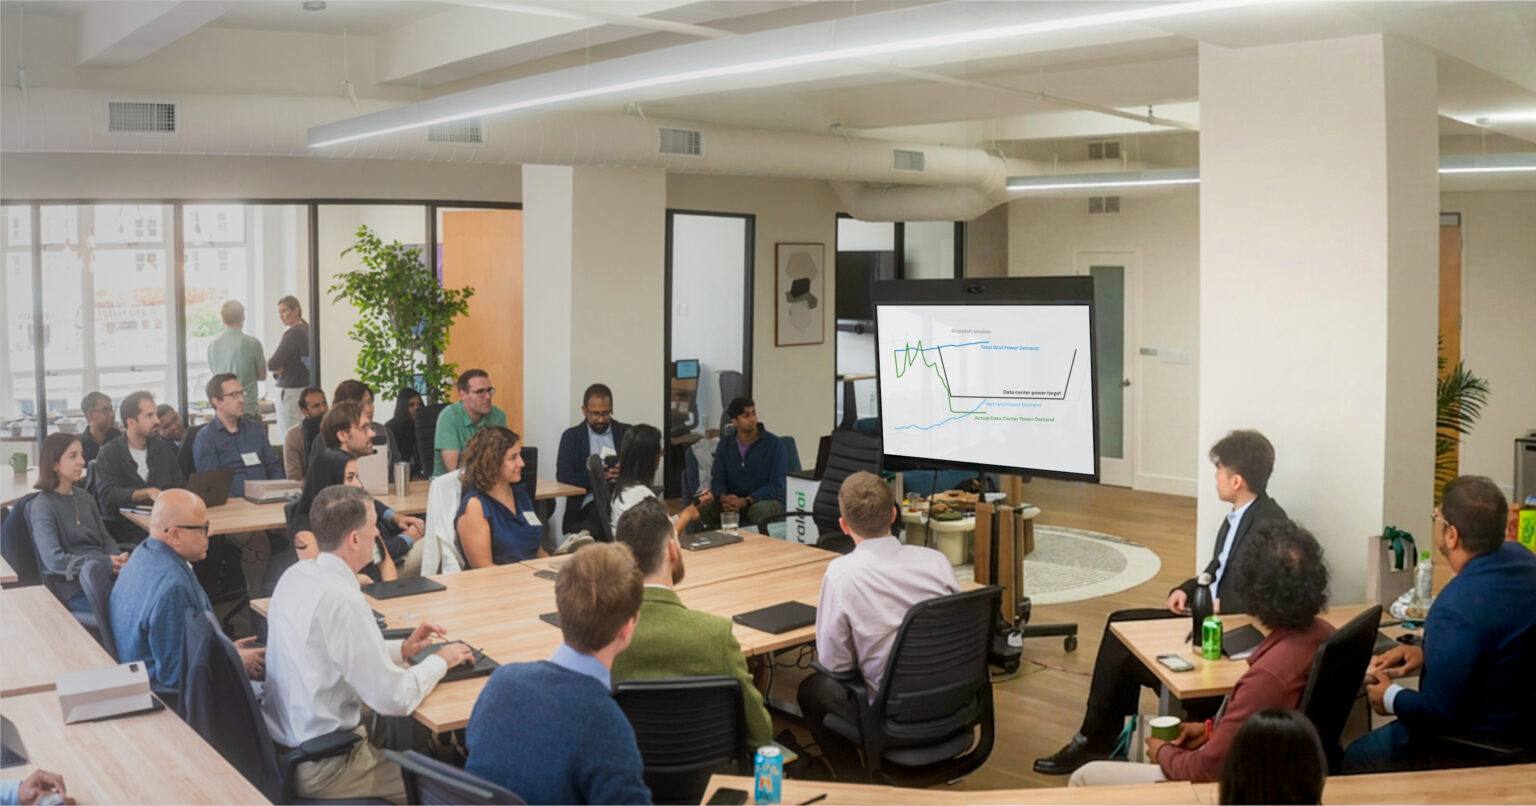
Efisiensi internal saja belum cukup ketika jaringan listrik sedang terbebani. NVIDIA menempatkan fleksibilitas grid sebagai lapisan berikutnya melalui DSX Flex. Sistem ini menerima sinyal seperti demand response, pengurangan beban, atau perubahan harga listrik, lalu menyesuaikan prioritas pekerjaan tanpa mengorbankan layanan yang paling kritis.
Contoh komersialnya terlihat pada NVIDIA Eos AI factory yang menggunakan Emerald AI Conductor dalam program Flexible Load Interconnect milik Silicon Valley Power. Saat menerima sinyal, sistem dapat menurunkan konsumsi dari empat megawatt menjadi tiga megawatt dalam waktu kurang dari satu menit. Pekerjaan berprioritas rendah diperlambat atau dijadwalkan ulang, sementara inferensi prioritas tinggi tetap berjalan.
Bagi operator, mekanisme ini membuka peluang untuk beroperasi lebih besar tanpa selalu menunggu kapasitas grid baru. Bagi penyedia listrik, pusat data dapat berperan sebagai beban yang dapat diatur, bukan sekadar konsumen pasif. Keberhasilan strategi ini tetap bergantung pada hierarki workload yang jelas dan aturan layanan yang transparan agar pengalaman pengguna tidak terganggu.
Arsitektur 800V DC dan pentingnya desain menyeluruh
Kepadatan rak komputasi terus meningkat, sehingga jalur distribusi daya tradisional menghadapi kompleksitas konversi dan keterbatasan skala. Arsitektur 800V DC dalam referensi DSX ditujukan untuk menyederhanakan pengiriman daya, meningkatkan efisiensi, dan mendukung rak accelerated computing yang lebih padat. NVIDIA memproyeksikan peningkatan efisiensi end-to-end sekitar 3–5% dibandingkan distribusi 54V pada implementasi yang sesuai.
Namun, arsitektur listrik bukan jawaban tunggal. Rak GB200 NVL72 dengan pendinginan cair langsung, misalnya, tetap menghasilkan panas sekitar 120 kW yang harus dikelola. Karena itu, DSX menggabungkan perangkat simulasi sebelum pembangunan, perangkat lunak operasi setelah fasilitas aktif, serta reference design yang telah divalidasi. Strategi ini memungkinkan pembangun mengidentifikasi hambatan lebih awal sebelum modal terikat pada desain yang kurang tepat.
Apa arti pendekatan ini bagi bisnis?
Bagi penyedia cloud, perusahaan, dan pengelola infrastruktur, pengukuran produksi AI per megawatt menggeser fokus dari sekadar jumlah GPU ke hasil layanan. Prioritas berikut menjadi lebih jelas:
- Petakan beban kerja yang benar-benar sensitif terhadap latensi dan yang dapat ditunda.
- Ukur kapasitas menganggur yang berasal dari kebijakan daya statis, bukan hanya utilisasi rata-rata GPU.
- Rancang daya, jaringan, pendinginan, dan operasi sebagai satu keputusan arsitektur.
- Bangun tata kelola agar penyesuaian beban saat grid terbatas tetap melindungi perjanjian tingkat layanan.
Dengan kerangka ini, investasi infrastruktur dapat diarahkan pada peningkatan output AI, bukan hanya penambahan kapasitas nominal.
Kesimpulan
Masa depan AI factory akan ditentukan oleh kemampuan menghasilkan lebih banyak token dari sumber daya yang sama. NVIDIA DSX menunjukkan bahwa jawabannya bukan hanya GPU yang lebih kuat, melainkan orkestrasi daya, workload, jaringan, pendinginan, dan operasi sebagai satu sistem. Dari alokasi daya dinamis hingga respons otomatis terhadap kondisi grid, pendekatan menyeluruh ini membantu operator mengubah batas megawatt menjadi keunggulan produksi yang terukur. Pada akhirnya, infrastruktur terbaik bukan yang memakai energi paling besar, tetapi yang mengubah setiap watt menjadi pekerjaan paling bernilai.


Leave a Reply
You must be logged in to post a comment.